27 августа VK описала применение многозадачного нейроранкера DCDN в рекомендательной системе Discovery-платформы. По данным компании, новая архитектура заменила градиентный бустинг на финальной стадии сортировки контента и автоматически извлекает нелинейные зависимости из исходных данных вместо ручного конструирования множества признаков.
До финального ранжирования двухбашенная модель и кросс-доменная модель «Хеймдаль» формируют для пользователя пул из нескольких тысяч кандидатов. Затем DCDN объединяет высокоразмерные представления с динамическим контекстом и рассчитывает оценки для окончательного упорядочивания ленты. Обратная связь — клики, досмотры и пропуски — возвращается в облачный контур регулярного дообучения.
Входные непрерывные признаки проходят кусочно-линейное кодирование: диапазон значений делится на интервалы по частоте встречаемости в журналах, после чего значение представляется через обучаемые векторы соседних границ. Ядро DCDN, созданное на основе Deep & Cross Network, моделирует сочетания признаков без постоянного увеличения размерности представления.
Ключевым изменением VK называет встроенную в архитектуру операцию деления. Она нужна для относительных сигналов — например, отношения кликов к показам или доли досмотров. Компания утверждает, что сеть может выводить такие зависимости из исходных счётчиков, сокращая потребность в ручном создании дробных признаков.
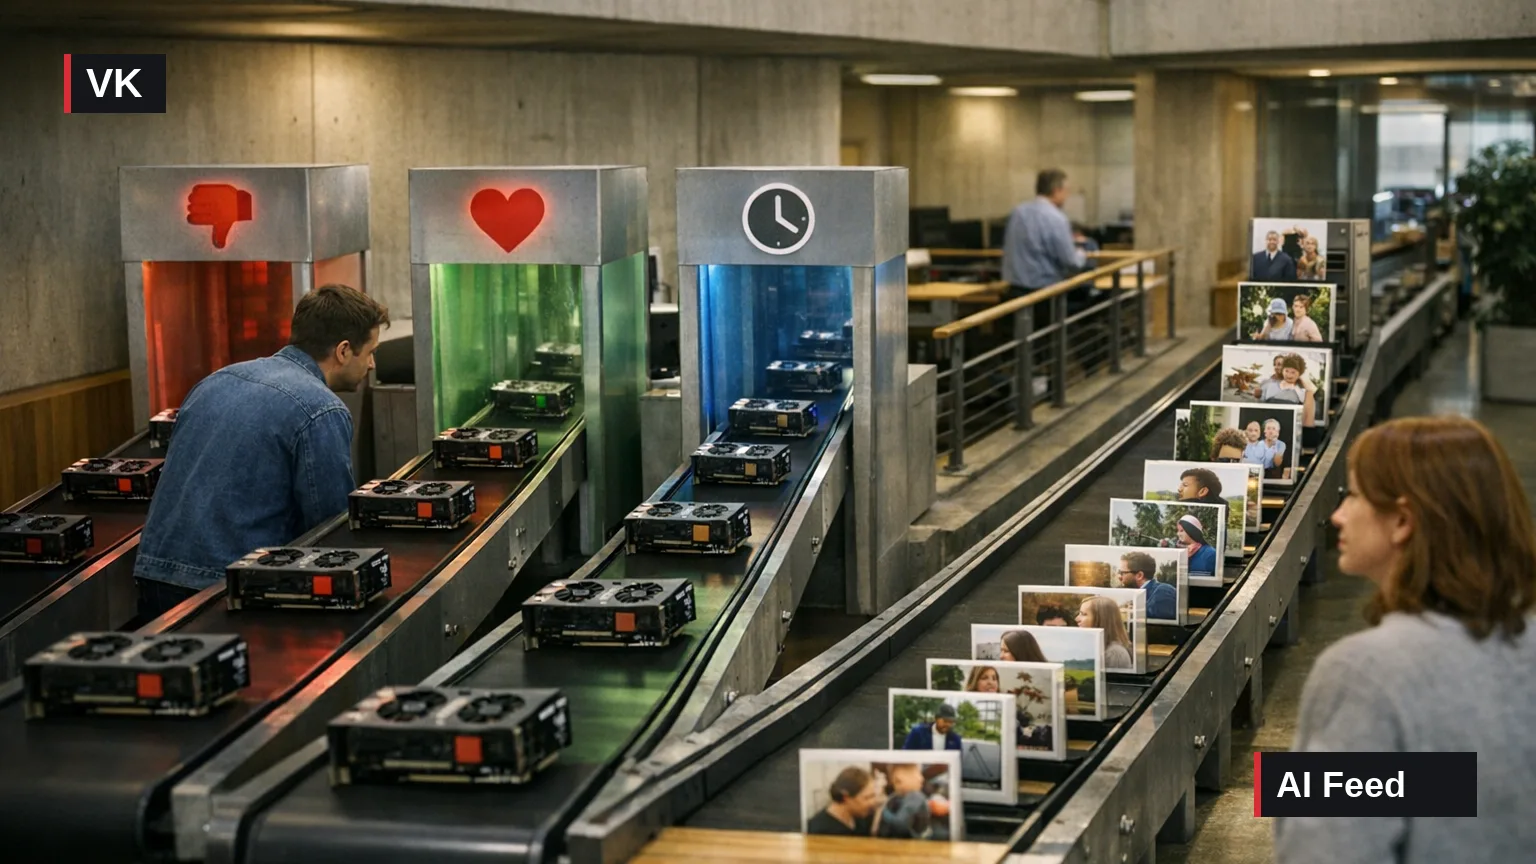
У модели три независимые выходные головы: вероятность лайка, риск дизлайка или скрытия материала и ожидаемое время вовлечённого просмотра. Их градиенты разделены с помощью stop_gradient, а отдельная компактная сеть обучения ранжированию объединяет прогнозы в итоговую оценку. По описанию VK, комбинацию сигналов можно менять во время работы без переобучения общего ядра.
Для времени просмотра команда отказалась от регрессии со среднеквадратичной ошибкой. Вместо одной усреднённой оценки модель прогнозирует иерархическую смесь экспоненциального распределения для быстрых пропусков и гауссовых распределений для вовлечённого просмотра. Чтобы избежать схлопывания дисперсий, VK применила равномерную инициализацию средних и регуляризационный штраф относительно эмпирического распределения.
Практический контекст: VK сообщила, что вероятностное моделирование времени просмотра увеличило общее время просмотра в VK Клипах на 5,5%, число лайков — на 5%, а репостов — на 15%, без снижения остальных метрик. Это результаты внутреннего кейса компании; независимое воспроизведение или описание экспериментального дизайна на странице не приведены. Практически архитектура интересна командам, у которых цели имеют несколько режимов поведения, а значительная часть признаков выражается отношениями величин.
| Выход модели | Что прогнозирует |
|---|---|
| Лайк | Вероятность явного лайка |
| Негативная реакция | Вероятность дизлайка или скрытия контента |
| Просмотр | Ожидаемое время вовлечённого просмотра |
Источники
Дата события: 2026-08-27. Дата первоисточника: 2026-08-27.