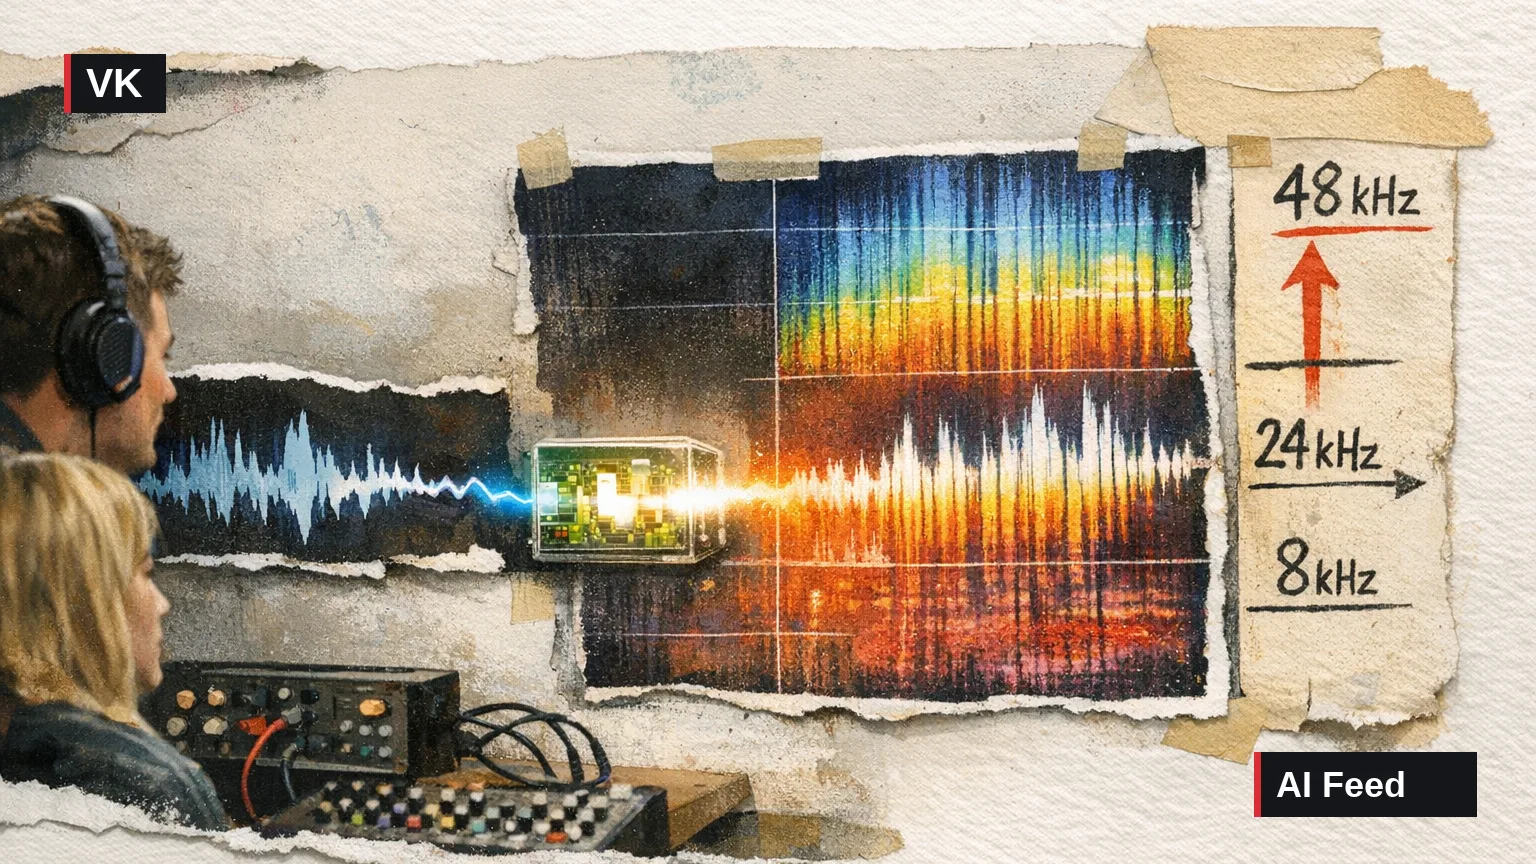
VK 16 сентября сообщила о FastWave — компактной диффузионной модели, которая расширяет полосу аудиосигнала с повышением частоты дискретизации до 48 кГц. Проект появился в совместной мастерской НИУ ВШЭ и VK, посвящённой сервисам и платформам ИИ. По данным разработчиков, модель может принимать аудио с разной исходной частотой дискретизации и оценивать недостающие высокочастотные компоненты.
FastWave насчитывает 1,3 млн параметров и требует 12,9 GFLOPs на один вызов. Основной режим использует четыре последовательных вызова, поэтому заявленная вычислительная сложность составляет около 50 GFLOPs. Взятая за основу NU-Wave 2 содержит 1,8 млн параметров, требует 19 GFLOPs на вызов и обычно выполняет восемь шагов генерации.
Для сокращения модели команда адаптировала к аудио методологию EDM: предсказание чистого сигнала вместо шума, зависимое от уровня шума масштабирование входов и выходов, логнормальное распределение уровней шума, взвешенную L2-функцию потерь и непрерывное расписание генерации. Обычные свёртки в архитектуре заменили разделяемыми и добавили Global Response Normalization для взаимодействия каналов. По оценке разработчиков, это уменьшило число параметров относительно NU-Wave 2 на 30% при сохранении качества реконструкции в проведённых ими экспериментах.
Модель обучали на речевом наборе VCTK, включающем 110 дикторов и около 44 часов записей с частотой дискретизации 48 кГц. Сто дикторов вошли в обучающую выборку, восемь — в тестовую. Команда проверяла повышение частоты дискретизации с 8, 12, 16 и 24 кГц до 48 кГц; обучение на одной NVIDIA V100 занимало до 30 часов.
В сравнении для преобразования 24→48 кГц FastWave с четырьмя шагами показала SNR 27,09 и LSD 0,93. У NU-Wave 2 с восемью шагами значения составили 27,68 и 0,78, а у FlowHigh с одним шагом — 27,80 и 0,74. Таким образом, FastWave не лидировала по этим метрикам, но была компактнее: 1,3 млн параметров против 49,4 млн у FlowHigh.
Практический контекст: Практически FastWave предлагает компромисс между компактностью, числом последовательных вычислений и измеренным качеством. Результаты указывают на потенциал для потоковой обработки речи на устройствах с GPU, однако источник не приводит испытаний на CPU, мобильных ускорителях, музыке или других типах аудио вне речевого набора VCTK. Все показатели опубликованы самой командой; независимое воспроизведение в материале не описано.
Разработчики опубликовали код и предварительно обученную контрольную точку на GitHub по ссылкам со страницы проекта. Они также сообщили, что научная статья с результатами FastWave принята на конференцию Interspeech 2026.
| Модель | NFE | SNR ↑ | LSD ↓ |
|---|---|---|---|
| AudioSR | 1 | 23,03 | 1,27 |
| FlowHigh | 1 | 27,80 | 0,74 |
| NU-Wave 2 | 8 | 27,68 | 0,78 |
| FastWave | 4 | 27,09 | 0,93 |
| FastWave | 8 | 27,22 | 0,83 |
| Модель | NFE | SNR ↑ | LSD ↓ |
|---|---|---|---|
| NU-Wave 2, базовая | 8 | 17,47 | 1,31 |
| NU-Wave 2 + EDM | 4 | 16,72 | 1,25 |
| NU-Wave 2 + EDM | 8 | 16,02 | 1,21 |
| FastWave | 4 | 18,49 | 1,22 |
| FastWave | 8 | 18,10 | 1,26 |
Как читать показатели сравнения
SNR обозначает отношение сигнала к шуму: большее значение считается лучшим. LSD измеряет расстояние между спектрами: меньшее значение считается лучшим. NFE показывает число последовательных вызовов модели при генерации.
Источники
Дата события: 2026-09-16. Дата первоисточника: 2026-09-16.