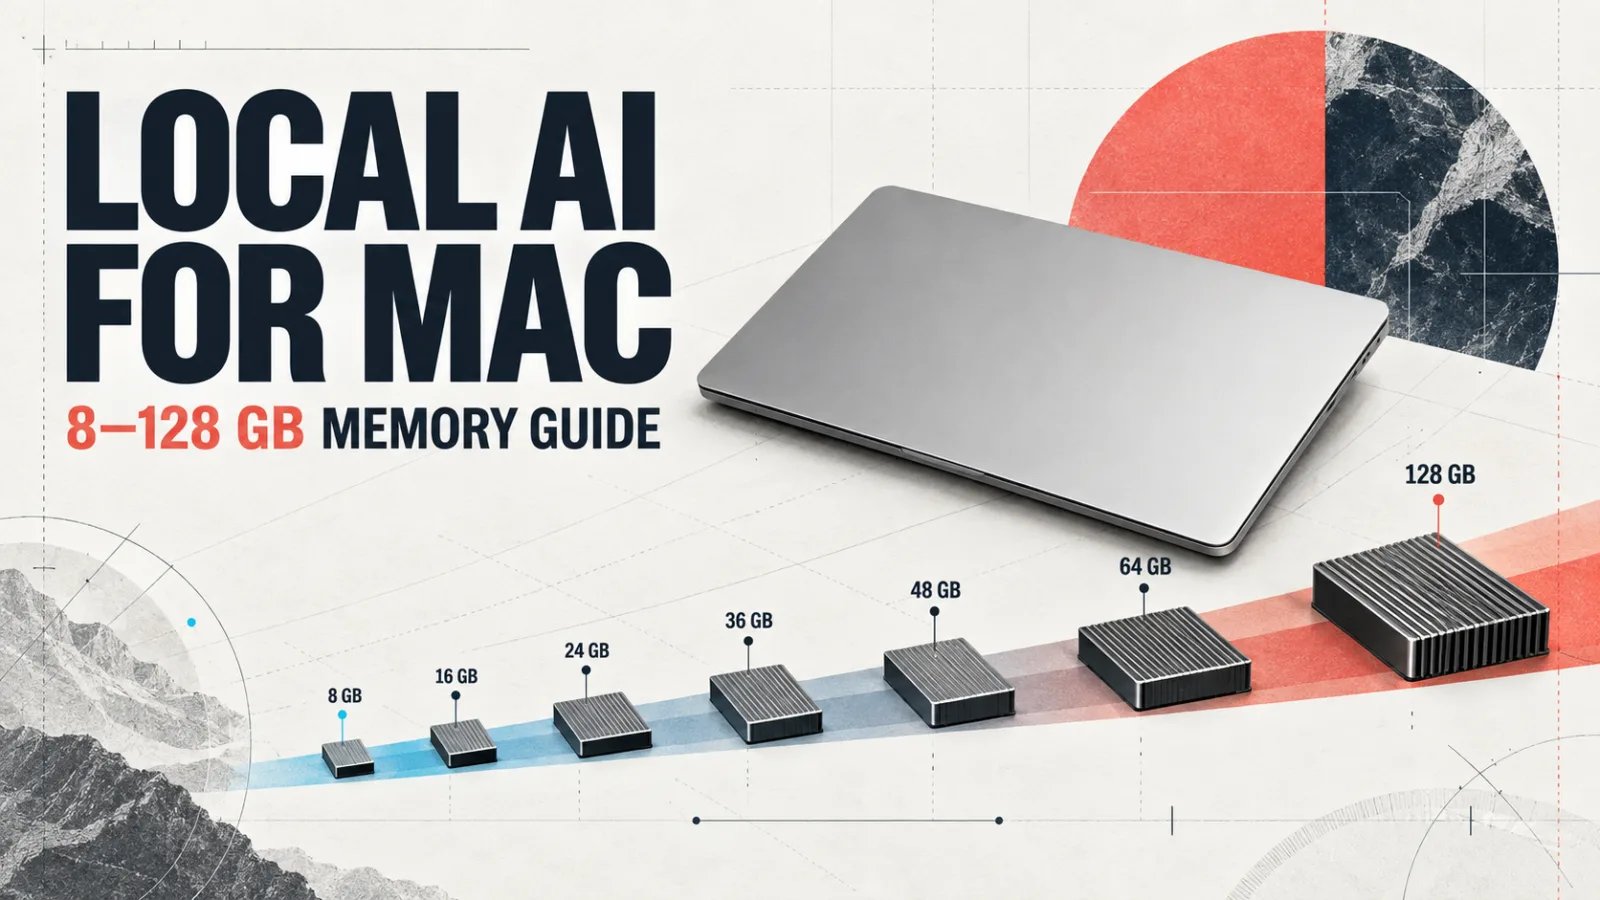
Главное правило локального AI на Mac: выбирайте модель не по названию чипа, а по объёму unified memory. Для обычной работы оставляйте системе и контексту не менее 25–30% памяти. Поэтому Mac с 24 ГБ комфортно работает с моделями размером примерно до 14–17 ГБ, а файл на 24 ГБ для него уже слишком велик.
Короткий ответ
- 8 ГБ: небольшие модели 2–4B, короткие запросы и простое извлечение текста.
- 16 ГБ: универсальные 7–9B; gpt-oss-20b запускается в 16 ГБ, но оставляет мало рабочего запаса.
- 24 ГБ: лучший массовый уровень для 9–20B и некоторых 27B-квантов с умеренным контекстом.
- 36–48 ГБ: комфортный диапазон для 27–35B, локального кодинга и документов.
- 64 ГБ: 70B в 4-битной квантизации становится практическим, хотя скорость зависит от пропускной способности памяти.
- 96–128 ГБ: крупные 70–120B, длинный контекст и несколько параллельных процессов.
Ниже — не рейтинг «самой умной нейросети». Это руководство по совместимости: что реально помещается в память, какой запас нужен и где локальный запуск имеет смысл. Актуальные модели, лицензии и популярность можно проверить в мониторинге локального AI.
Таблица выбора: какая модель подходит вашему Mac
| Память Mac | Разумный размер весов | Класс модели | Практический сценарий | Главное ограничение |
|---|---|---|---|---|
| 8 ГБ | до 3–4 ГБ | 2–4B Q4 | Короткий чат, классификация, извлечение данных | Мало места для контекста и других приложений |
| 16 ГБ | до 7–10 ГБ | 7–9B Q4/Q6 | Тексты, документы, лёгкий кодинг | 20B запускается на пределе |
| 24 ГБ | до 14–17 ГБ | 14–20B, отдельные 27B Q4 | Код, RAG, аналитика, постоянный локальный помощник | 27B требует короткого контекста и закрытых приложений |
| 36 ГБ | до 24–26 ГБ | 27–35B Q4 | Серьёзный кодинг, изображения + текст, агенты | Большой контекст быстро съедает запас |
| 48 ГБ | до 32–35 ГБ | 35B Q6 или облегчённые 70B | Крупные репозитории, длинные документы, несколько агентов | Полноценный 70B всё ещё тесен |
| 64 ГБ | до 44–48 ГБ | 70B Q4 | Сильный универсальный ассистент, сложный код и анализ | Скорость ниже, чем у небольших MoE-моделей |
| 96–128 ГБ | до 65–85 ГБ | 70B высокой точности, 120B-класс | Большие модели, длинный контекст, серверный режим | Высокая цена компьютера и энергозатраты |
«Разумный размер весов» — редакционный ориентир AI Feed, а не технический предел. Он оставляет место для macOS, приложения, KV-кэша и рабочего контекста. Реальный расход зависит от runtime, квантизации и длины диалога.
Почему объём памяти важнее названия M4 или M5
Apple Silicon использует единую память: CPU и GPU обращаются к одному пулу. В MLX массив не нужно отдельно копировать в видеопамять — процессоры работают с общей памятью напрямую. Для локальных моделей это удобно: почти весь доступный объём можно использовать как память ускорителя.
Но эта же архитектура означает конкуренцию за один ресурс. Модель, Safari, IDE, Docker, графическая система и KV-кэш живут в одном пуле. Если веса заняли почти всю память, macOS начинает активно использовать swap. Модель формально запускается, но ответы замедляются, система перестаёт быть комфортной, а длинный контекст может завершить процесс.
Модель, которая загрузилась, ещё не является моделью, с которой удобно работать.
Из чего складывается расход памяти
Минимальная оценка выглядит так:
память = веса модели + KV-кэш + вычислительные буферы + runtime + macOS и приложения.
- Веса обычно занимают большую и заранее известную часть. Для Q4 это грубо около половины байта на параметр плюс служебные данные.
- KV-кэш хранит контекст диалога. Чем длиннее запрос и история, тем больше память.
- Вычислительные буферы зависят от архитектуры модели и среды запуска.
- Система должна сохранить запас для интерфейса, браузера, редактора и фоновых процессов.
Именно поэтому размер в каталоге Ollama или Hugging Face нельзя просто сравнить с цифрой на коробке Mac. Например, Qwen 3.5 27B в Ollama занимает около 17 ГБ: на 24‑гигабайтной машине он может работать, но после загрузки остаётся мало места для большого контекста, IDE и браузера. На 36 ГБ та же модель становится гораздо спокойнее.
Что запускать на 8 ГБ
Восемь гигабайт — режим небольших моделей. Рассматривайте Qwen 3.5 2B/4B, Phi‑4 Mini в компактной квантизации и похожие модели размером до 3–4 ГБ. Они подходят для классификации, извлечения полей, переписывания коротких фрагментов, простых вопросов и локального автодополнения.
Не стоит ожидать надёжной работы с большим проектом или длинным документом. Даже если 7–9B загрузится, давление на память быстро уберёт преимущество локального запуска. Для тяжёлой задачи выгоднее отправить отдельный запрос в облако.
Что запускать на 16 ГБ
Это минимальный универсальный уровень. На нём разумно использовать Qwen 3.5 9B, компактные версии Gemma и 7–9B модели в Q4/Q5. Они уже способны редактировать тексты, отвечать по локальным документам и помогать с небольшими функциями.
OpenAI указывает, что gpt‑oss‑20b может работать в 16 ГБ памяти, а сборка Ollama занимает примерно 14 ГБ. Это хороший пример разницы между «может запуститься» и «комфортно работает»: на 16‑гигабайтном Mac запас будет минимальным. Для постоянной работы с этой моделью 24 ГБ безопаснее.
Что запускать на 24 ГБ
Для большинства покупателей это первая действительно удобная конфигурация локального AI. Она позволяет держать сильную 9–14B модель вместе с браузером и редактором либо запускать gpt‑oss‑20b с нормальным запасом. Qwen 3.5 27B размером около 17 ГБ тоже возможен, если уменьшить контекст и закрыть тяжёлые приложения.
Практический выбор:
- для повседневного помощника и работы с изображениями — Qwen 3.5 9B;
- для рассуждений и агентных задач — gpt‑oss‑20b;
- для экспериментов с более сильной моделью — Qwen 3.5 27B Q4 с умеренным контекстом;
- для кода — 9–20B модель плюс отдельный агент, который умеет читать файлы и запускать тесты.
MacBook Pro с 24 ГБ подходит для локального вайбкодинга, но модель не заменяет среду агента. Качество зависит не только от весов: важны доступ к репозиторию, команды проверки, управление контекстом и способность модели пользоваться инструментами.
Что запускать на 36 и 48 ГБ
Это наиболее сбалансированный диапазон для серьёзной локальной работы. Qwen 3.5/3.6 класса 35B, Gemma 4 26B и другие модели размером 20–25 ГБ оставляют место для контекста, IDE и браузера. На 48 ГБ можно выбирать более точную квантизацию или запускать несколько процессов.
Официальная MLX‑квантизация Qwen 3.6 35B занимает около 23 ГБ. На Mac с 36 ГБ она уже практична; на 24 ГБ её запуск превращается в борьбу за каждый гигабайт. Версия Gemma 4 26B в Q4 интересна тем, кому требуется понимание изображений вместе с текстом.
Для разработчика 36–48 ГБ часто полезнее, чем погоня за максимальным числом GPU‑ядер при меньшей памяти. Ядра определяют скорость, но нехватка памяти вообще закрывает доступ к нужному классу модели.
Что запускать на 64 ГБ
При 64 ГБ становятся реалистичными 70B‑модели в Q4. Их веса обычно занимают около 42–48 ГБ, поэтому остаётся ограниченный, но рабочий запас. Они полезны для сложного анализа, редактирования больших документов и задач, где небольшие модели часто теряют инструкции.
Однако больше параметров не всегда означает лучший пользовательский опыт. Современная MoE‑модель 35B может отвечать быстрее и лучше пользоваться инструментами, чем старый плотный 70B. Сравнивайте качество на собственной задаче, скорость первого токена и стабильность длинного сеанса.
Что дают 96 и 128 ГБ
Этот объём нужен тем, кто осознанно запускает крупные модели, сервер для нескольких устройств или очень длинный контекст. OpenAI оценивает потребность gpt‑oss‑120b примерно в 80 ГБ, поэтому практическая конфигурация начинается с 96 ГБ. На 128 ГБ появляется запас для приложений и нескольких пользователей.
Для обычного личного помощника такая покупка редко окупается. Облачная модель может оказаться быстрее, сильнее и дешевле, если тяжёлые запросы выполняются несколько раз в неделю. Сравнить порядок расходов можно в нашем калькуляторе стоимости AI API.
Ollama, MLX или llama.cpp
| Среда | Когда выбирать | Сильная сторона | Компромисс |
|---|---|---|---|
| Ollama | Первый запуск, приложения и агенты | Простая установка, каталог и локальный API | Не всегда самый гибкий контроль квантизации |
| MLX / MLX‑LM | Apple Silicon и готовые MLX‑веса | Нативная работа с unified memory | Не каждая модель сразу получает качественную конверсию |
| llama.cpp | Нужны GGUF, тонкая настройка и переносимость | Metal включён на macOS, много параметров запуска | Больше ручной настройки |
Новичку стоит начать с Ollama или LM Studio. Пользователю Apple Silicon, которому важна эффективность и доступна нужная конверсия, — попробовать MLX. llama.cpp удобен для тех, кто хочет точно управлять контекстом, GPU‑слоями, кэшем и серверным режимом.
Код, изображения и видео — это разные нагрузки
Программирование
Для кода важны следование инструкциям, вызов инструментов и работа с репозиторием. На 24 ГБ разумнее сильная 9–20B модель с хорошим агентом, чем тяжёлая модель без памяти для контекста. Для больших репозиториев 36–48 ГБ заметно удобнее.
Изображения
Диффузионные модели используют память иначе, чем LLM. Компактные генераторы работают на 16–24 ГБ, но высокое разрешение, несколько ControlNet и большие batch‑размеры требуют больше. Возможность LLM понимать картинку не означает, что она сама генерирует изображение.
Видео
Локальное видео остаётся самой тяжёлой задачей. На 24–36 ГБ возможны короткие ролики с компактными моделями и длительным ожиданием, но это не аналог облачных видеосервисов. Покупать Mac только ради локального видео стоит после проверки конкретной модели и разрешения.
Как выбрать Mac для локального AI
- Определите главный сценарий. Чат, код, поиск по документам, изображения и видео требуют разного железа.
- Выберите класс модели. Для повседневных задач начните с 9–20B; 35B нужен не всем.
- Найдите размер нужной квантизации. Смотрите фактический файл в Ollama, MLX Community или GGUF‑репозитории.
- Добавьте не менее 25–30% запаса. Для длинного контекста, Docker и тяжёлой IDE — ещё больше.
- Только после этого сравнивайте чипы. При одинаковой памяти Max обычно быстрее Pro, но не вместит более крупную модель.
Что покупать
- 16 ГБ: если локальный AI нужен для знакомства и небольших моделей.
- 24 ГБ: лучший минимальный выбор для регулярного использования и gpt‑oss‑20b.
- 36–48 ГБ: оптимум для разработчика, локальных агентов и 27–35B.
- 64 ГБ: если точно нужен 70B‑класс или несколько моделей одновременно.
- 96–128 ГБ: рабочая станция или домашний сервер, а не обязательный апгрейд для всех.
Частые вопросы
Можно ли запустить локальную нейросеть на Mac с 8 ГБ?
Да, если выбрать модель 2–4B в компактной квантизации и не использовать длинный контекст. Для серьёзного кодинга и больших документов 8 ГБ недостаточно.
Хватит ли 24 ГБ для локального AI?
Да. Это практичный объём для 9–20B и отдельных 27B‑квантов. Для комфортной работы с 35B лучше 36–48 ГБ.
Можно ли запустить 70B на 64 ГБ?
Обычно да в 4‑битной квантизации, если файл весов занимает около 42–48 ГБ. Контекст и приложения всё равно нужно контролировать.
Что важнее: M4 Max или больше памяти?
Если выбор влияет на класс модели, сначала берите память. Более быстрый чип ускоряет модель, но не исправляет ситуацию, когда она не помещается.
Работает ли локальный AI без интернета?
После скачивания весов многие runtimes могут работать без сети. Но веб‑поиск, внешние API, обновления и облачные инструменты требуют подключения.
Локальная модель полностью конфиденциальна?
Запросы могут оставаться на устройстве, если runtime не обращается к внешним сервисам. Проверяйте настройки приложения, плагины, телеметрию и лицензию модели.
Методика и источники
Таблица объединяет официальные размеры опубликованных весов, заявления разработчиков и практический запас памяти AI Feed. Мы не измеряли скорость каждой конфигурации на одном стенде, поэтому не выдаём расчёт совместимости за сравнительный benchmark. Рекомендации будут обновляться вместе с каталогом моделей.
- Apple MLX: Unified Memory
- llama.cpp: сборка и Metal на macOS
- Ollama: Qwen 3.5 и размеры вариантов
- OpenAI: требования gpt‑oss‑20b и gpt‑oss‑120b
- Hugging Face: gpt‑oss‑20b
- Google: Gemma 4 26B Q4 GGUF
- Qwen: Qwen 3.6 35B A3B
- Microsoft: Phi‑4 Mini Instruct
Обновлено 25 сентября 2026 года. Размеры и совместимость относятся к конкретным квантизациям и могут измениться после обновления runtime.